La IA Refuta la Hipótesis del Tiempo Exponencial: ¿El Mayor Avance en Computación Teórica de la Historia Reciente?
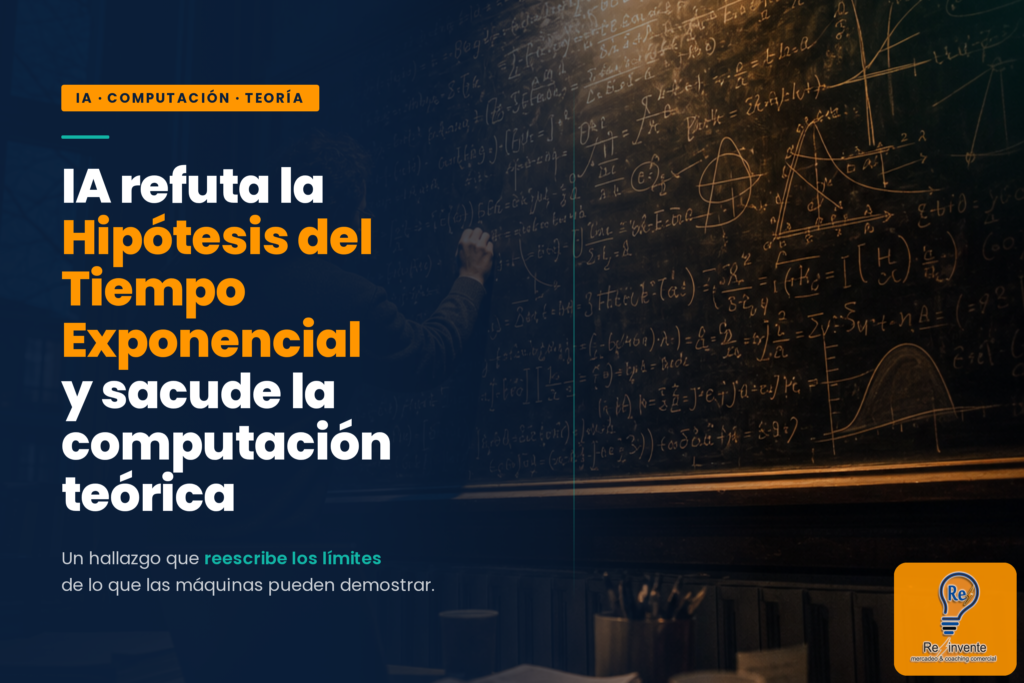
El 27 de octubre de 2026, el mundo de la informática teórica y la inteligencia artificial fue sacudido por un anuncio que pocos habrían imaginado posible: varios laboratorios de IA de frontera, con OpenAI a la cabeza, afirmaron que sus modelos de inteligencia artificial habrían logrado refutar la Hipótesis del Tiempo Exponencial (ETH, del inglés Exponential Time Hypothesis). La noticia, recogida por TechCrunch con la participación explicativa de un científico computacional del MIT, fue descrita como verdaderamente desconcertante, y sus implicaciones podrían redefinir los fundamentos mismos de cómo entendemos la computación, la criptografía y la inteligencia artificial clásica.
Para comprender la magnitud de este anuncio, es necesario detenerse a explicar qué es exactamente la ETH, por qué ha sido tan relevante durante más de dos décadas y qué significa que un sistema de inteligencia artificial pueda haberla invalidado.
¿Qué es la Hipótesis del Tiempo Exponencial y por qué importa tanto?
La Hipótesis del Tiempo Exponencial fue formulada en 2001 por los informáticos teóricos Russell Impagliazzo y Ramamohan Paturi, y desde entonces se convirtió en uno de los pilares centrales de la teoría de la complejidad computacional moderna. En términos simplificados, la ETH establece que ciertos problemas fundamentales —en especial el problema de satisfacibilidad booleana o SAT, el primero en demostrarse como NP-completo— no pueden resolverse en tiempo subexponencial.
Más concretamente, la hipótesis postula que el problema conocido como 3-SAT —una variante del SAT donde cada cláusula tiene exactamente tres literales— no puede resolverse en tiempo 2o(n), donde n es el número de variables del problema. En otras palabras, no existe ningún algoritmo capaz de encontrar una solución de forma significativamente más rápida que recorriendo de manera esencialmente exponencial el espacio de posibles respuestas.
Es importante distinguir la ETH del célebre problema abierto P vs NP, aunque ambas cuestiones estén relacionadas. Mientras que P vs NP pregunta si todo problema cuya solución puede verificarse rápidamente también puede resolverse rápidamente, la ETH va un paso más allá: no solo afirma que ciertos problemas son difíciles, sino que cuantifica exactamente cuán difíciles son en términos de la tasa de crecimiento del tiempo necesario para resolverlos. Esta característica la convirtió en una herramienta extraordinariamente poderosa para demostrar cotas inferiores de complejidad en centenares de problemas distintos.
Durante más de veinte años, la ETH ha servido como base para resultados en áreas tan diversas como los algoritmos de grafos, la criptografía, la bioinformática, la planificación logística y la propia inteligencia artificial clásica. Si esa base se derrumba, muchas de las conclusiones construidas sobre ella también quedan en entredicho, abriendo la puerta a algoritmos radicalmente más eficientes en dominios que se consideraban computacionalmente intratables.
El contexto: la IA como herramienta de investigación matemática avanzada
Este anuncio no llegó en el vacío. Durante los últimos años, los grandes laboratorios de inteligencia artificial han apostado con fuerza por el uso de sus modelos como asistentes de investigación matemática avanzada. Los hitos en esta dirección se han sucedido de forma acelerada:
AlphaProof y AlphaGeometry de Google DeepMind demostraron la capacidad de los sistemas de IA para resolver problemas de olimpiadas matemáticas al nivel de medalla de plata en la Olimpiada Internacional de Matemáticas (IMO). Por su parte, OpenAI lanzó modelos de la familia o1 y versiones posteriores aún más avanzadas, específicamente orientadas al razonamiento matemático formal, capaces de trabajar con sistemas de demostración automática como Lean 4 y Coq. Más recientemente, varios laboratorios comenzaron a publicar resultados en los que sus modelos contribuían a demostraciones de teoremas no resueltos o simplificaban pruebas existentes de forma significativa.
Sin embargo, afirmar que un modelo de IA ha refutado la ETH representa un salto cualitativo de una magnitud incomparable respecto a todos esos antecedentes. No se trata de resolver un problema de olimpiada ni de verificar una demostración humana preexistente. Se trata de producir un resultado que invalida una hipótesis central de la teoría de la complejidad computacional, un área donde los avances históricos han sido extraordinariamente escasos y lentos, y donde incluso los errores sutiles pueden tardar años en ser detectados.
Las consecuencias revolucionarias de una refutación válida
Si la refutación de la ETH resulta ser matemáticamente válida y supera el escrutinio de la comunidad académica, las implicaciones serían verdaderamente revolucionarias en múltiples dimensiones simultáneas.
En el ámbito de la teoría de la complejidad, la caída de la ETH obligaría a revisar un corpus enorme de la literatura académica. Cientos de resultados de hardness —es decir, demostraciones de que ciertos algoritmos eficientes son imposibles— están construidos sobre la ETH como hipótesis fundamental. Si esta hipótesis es falsa, todos esos resultados dejan de ser concluyentes, lo que no significa necesariamente que los algoritmos eficientes existan, pero sí que ya no tenemos argumentos sólidos para descartar su existencia.
En criptografía, aunque los sistemas modernos más utilizados descansan principalmente sobre hipótesis como la dificultad de factorizar números grandes o el logaritmo discreto, parte de la criptografía basada en lattices —redes algebraicas que forman la base de muchos esquemas post-cuánticos— tiene conexiones con problemas cuya dureza se argumenta apoyándose parcialmente en la ETH o en hipótesis relacionadas como la Strong ETH (SETH). Una refutación podría cuestionar la solidez de algunos de estos esquemas, con implicaciones directas para la seguridad digital de comunicaciones, transacciones financieras y datos sensibles.
En optimización y planificación, muchos problemas combinatorios actualmente considerados intratables para instancias grandes —planificación logística, diseño de redes de telecomunicaciones, plegamiento de proteínas, asignación de recursos— podrían resultar abordables con algoritmos más eficientes de lo que la ciencia creía posible. Las consecuencias industriales y científicas de este escenario serían difíciles de exagerar.
Respecto al problema P vs NP, una refutación de la ETH no equivale automáticamente a demostrar que P = NP, pero sí podría ser un paso significativo en la comprensión del problema o al menos redefinir radicalmente el paisaje teórico en el que ese problema existe. La comunidad matemática deberá analizar con extremo cuidado qué implica exactamente el resultado para la jerarquía completa de clases de complejidad computacional.
La verificación independiente: el estándar de oro que todo lo decide
Que TechCrunch haya acudido a un científico computacional del MIT para explicar el alcance del descubrimiento es un detalle que no debe pasarse por alto. La verificación independiente es absolutamente crítica en este tipo de anuncios. La historia de las matemáticas y la informática teórica está marcada por afirmaciones de grandes resultados que posteriormente revelaron errores sutiles pero fatales.
El caso más conocido y reciente fue la afirmación de resolución de P vs NP realizada por Vinay Deolalikar en 2010: en cuestión de días, la comunidad académica identificó los fallos de la demostración. Errores similares, aunque menos mediáticos, se han producido repetidamente en la historia de la complejidad computacional. La dificultad de estos problemas no reside solo en encontrar una solución, sino en construir una demostración que resista el escrutinio de los mejores especialistas del mundo.
En este caso, el estándar de oro que la comunidad matemática exigirá es claro: una demostración formal verificable por un asistente de pruebas automático, preferiblemente Lean 4, que no deje margen para errores humanos ocultos. Solo cuando esa verificación sea completada y reproducida de forma independiente podrá hablarse con propiedad de un resultado definitivo. La participación de instituciones académicas de primer nivel desde el primer momento sugiere que los laboratorios involucrados son plenamente conscientes del nivel de escrutinio que enfrentarán.
Un momento histórico pendiente de confirmación
Estamos, potencialmente, ante uno de los momentos más significativos en la historia de la informática teórica. Si la refutación de la ETH se confirma como válida, el papel de la inteligencia artificial en la investigación matemática habrá dado un salto cualitativo sin precedentes, pasando de asistente a descubridor de resultados fundamentales que escaparon a décadas de trabajo humano.
Sin embargo, la prudencia científica exige suspender el juicio hasta que la verificación independiente haya concluido. La grandeza de un resultado matemático no la determina el laboratorio que lo anuncia, sino la comunidad que lo verifica. En las próximas semanas y meses, los mejores especialistas en complejidad computacional del mundo tendrán la tarea de examinar este resultado con la misma rigurosidad con la que se ha construido toda la teoría que podría estar a punto de transformarse para siempre.
Lo que sí es indiscutible es que, independientemente del desenlace final, este anuncio marca un antes y un después en la conversación sobre qué pueden hacer —y qué podrían llegar a hacer— los sistemas de inteligencia artificial en el ámbito de la investigación científica y matemática de frontera. El debate acaba de comenzar.