OpenAI Refuerza Drásticamente las Defensas Contra la Extracción del Razonamiento Interno de Sus Modelos de IA
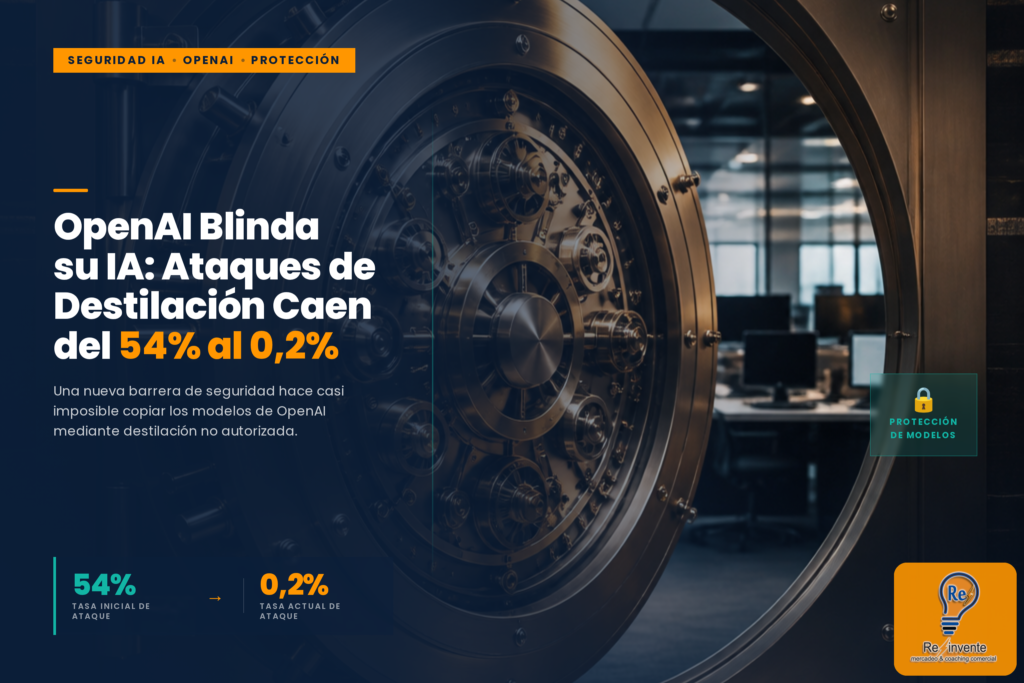
En uno de los movimientos de seguridad más significativos que ha llevado a cabo hasta la fecha, OpenAI ha anunciado la implementación de medidas de protección notablemente más robustas para blindar los procesos de razonamiento interno de sus modelos de inteligencia artificial más avanzados. Los protagonistas de esta historia son GPT-6.2 Astra y GPT-6.2 Sol, dos variantes especializadas de la familia GPT-6 que han pasado a ser los objetivos más codiciados por quienes intentan replicar las capacidades de OpenAI sin asumir los costos de investigación y desarrollo. El resultado más llamativo de estas nuevas defensas es estadísticamente contundente: la tasa de éxito en ataques de extracción de razonamiento protegido ha caído del 54% al 0,2% en pruebas de red-teaming adaptativo. Paralelamente, la compañía está suspendiendo entre miles y decenas de miles de cuentas cada semana vinculadas a campañas coordinadas de destilación no autorizada.
¿Qué es la Destilación de Modelos y Por Qué Representa una Amenaza?
Para entender la trascendencia de estas medidas, es necesario comprender primero el concepto técnico que las motiva. La destilación de modelos es, en su forma legítima, una técnica consolidada del aprendizaje automático. Consiste en que un modelo más pequeño —denominado “estudiante”— aprende a replicar el comportamiento de un modelo más grande y potente —denominado “profesor”—. El resultado es un sistema eficiente que conserva gran parte de las capacidades del modelo original a una fracción del costo computacional. En contextos legítimos, esta técnica es ampliamente utilizada para democratizar el acceso a la inteligencia artificial y reducir la huella energética de los sistemas desplegados.
El problema surge cuando esta misma técnica se aplica sin autorización sobre modelos comerciales protegidos. En ese escenario, los atacantes realizan miles o incluso millones de consultas sistemáticas a un modelo como GPT-6.2 Astra, registran meticulosamente las respuestas y utilizan ese cúmulo de datos para entrenar su propio sistema que imite las capacidades del original. El resultado: obtener las ventajas de años de investigación y billones de dólares en inversión sin haber incurrido en ninguno de esos costos. Se trata, en esencia, de una forma sofisticada de robo de propiedad intelectual.
Este debate no es nuevo. Empresas como DeepSeek fueron señaladas —aunque sin pruebas concluyentes— por haber utilizado outputs de modelos de OpenAI para acelerar el entrenamiento de sus propios sistemas. Aquellas acusaciones desencadenaron un debate global que hoy sigue siendo más relevante que nunca, y que ha impulsado directamente las medidas que OpenAI acaba de implementar.
Los Modelos en el Centro de la Batalla: GPT-6.2 Astra y GPT-6.2 Sol
Lanzados a lo largo de 2026, GPT-6.2 Astra y GPT-6.2 Sol representan la evolución más refinada de las cadenas de razonamiento extendidas y visibles que OpenAI inauguró con la serie “o”. Esta característica, conocida como visible chain-of-thought o cadena de pensamiento visible, fue concebida con un propósito noble: mejorar la transparencia y la auditabilidad de los modelos, permitiendo a los usuarios verificar paso a paso cómo el sistema llegó a una determinada conclusión.
Sin embargo, esta misma apertura diseñada para generar confianza se ha convertido en una superficie de ataque especialmente vulnerable. Si un adversario puede capturar de forma sistemática y masiva estos procesos de razonamiento paso a paso, obtiene algo mucho más valioso que simples respuestas finales: obtiene una ventana directa al “pensamiento” del modelo, lo que confiere una ventaja enorme para replicar sus capacidades.
La dificultad técnica de proteger este tipo de razonamiento es intrínsecamente mayor que en modelos que solo producen outputs finales. Se trata de una capa adicional de información que, por definición del diseño original, debe ser accesible al usuario legítimo. El reto de OpenAI ha sido, por tanto, extraordinariamente complejo: proteger esa información frente a la explotación sistemática sin degradar la experiencia del usuario honesto.
Los Nuevos Mecanismos de Protección: ¿Cómo Funciona el Escudo?
OpenAI ha sido prudentemente discreta respecto a los detalles técnicos específicos de sus nuevas defensas, lo cual es perfectamente comprensible desde una perspectiva de seguridad. Sin embargo, ha confirmado varias líneas de acción concretas que merecen ser analizadas en profundidad.
Detección conductual avanzada. La compañía ha desarrollado sistemas capaces de identificar patrones de consulta anómalos que sugieren actividad de destilación sistemática. Estos patrones incluyen volúmenes inusualmente altos de solicitudes desde una misma cuenta o conjunto de direcciones IP, consultas diseñadas específicamente para maximizar la exposición del razonamiento interno, y secuencias de preguntas que cubren de forma exhaustiva dominios concretos del conocimiento del modelo. La sofisticación de estos sistemas de detección es tal que pueden distinguir entre un investigador curioso que hace muchas preguntas y un actor malicioso que ejecuta una campaña coordinada de extracción.
Ofuscación selectiva del razonamiento. Se han implementado técnicas para proteger de forma selectiva las partes más sensibles del proceso de razonamiento interno sin que el usuario legítimo perciba una degradación significativa en la calidad de las respuestas. Esto incluye la supresión o modificación de ciertos pasos del razonamiento que revelarían información especialmente valiosa sobre la arquitectura y el entrenamiento subyacente del modelo.
Suspensión masiva de cuentas. El dato cuantitativamente más impactante es la suspensión de entre miles y decenas de miles de cuentas por semana. Esta cifra es reveladora de la verdadera escala del problema: las campañas de destilación no autorizada no son actividades marginales llevadas a cabo por actores individuales con recursos limitados, sino operaciones coordinadas, bien organizadas y de gran alcance. La capacidad de OpenAI para detectar y actuar sobre estas cuentas en tiempo cuasi-real implica que dispone de sistemas automatizados de respuesta de considerable madurez tecnológica.
Reducción drástica de la tasa de éxito. El salto estadístico del 54% al 0,2% en pruebas de red-teaming adaptativo es quizás el indicador más elocuente del éxito de estas medidas. El red-teaming adaptativo es una metodología en la que equipos de expertos en seguridad intentan activamente superar las defensas del sistema, ajustando continuamente sus técnicas en función de los resultados obtenidos. Que la tasa de éxito sea prácticamente cero en este contexto dinámico y adversarial es una medida de robustez excepcionalmente alta, comparable a las mejores prácticas en ciberseguridad convencional.
La Guerra por la Propiedad Intelectual en la Era de la IA
Esta noticia no puede entenderse de forma aislada. Se inscribe en un conflicto estructural más profundo que define la industria de la inteligencia artificial en 2026: la tensión entre la apertura necesaria para la usabilidad y la protección de inversiones astronómicas en investigación y desarrollo.
OpenAI ha invertido estimaciones de entre 10.000 y 15.000 millones de dólares en el desarrollo de sus modelos de frontera durante los últimos años. La posibilidad de que competidores —ya sean empresas, estados o actores no estatales— puedan replicar estas capacidades a través de la destilación no autorizada representa una amenaza existencial para el modelo de negocio de la compañía y, en sentido más amplio, para los incentivos económicos que sostienen la investigación en inteligencia artificial de frontera.
A nivel regulatorio, tanto la Unión Europea como los Estados Unidos están desarrollando marcos normativos que abordan específicamente la protección de los modelos de IA más avanzados. La Ley de IA de la UE, ya en vigor en sus disposiciones principales, contempla los modelos de propósito general de alto impacto como una categoría especial que requiere salvaguardas adicionales, aunque aún no aborda de forma directa la destilación no autorizada como práctica explícitamente ilegal. Esta laguna regulatoria es uno de los motivos por los que las empresas como OpenAI han optado por desarrollar sus propias defensas técnicas sin esperar a que el marco legal se ponga al día.
En paralelo, varios litigios activos en tribunales estadounidenses buscan establecer si los outputs de los modelos de IA pueden considerarse protegidos por derechos de autor. La respuesta a esa pregunta tendrá implicaciones directas y de largo alcance sobre la legalidad de las campañas de destilación, y podría transformar radicalmente las reglas del juego competitivo en el sector.
Implicaciones para los Usuarios y Desarrolladores Legítimos
Una pregunta que inevitablemente surge ante medidas de seguridad de esta magnitud es: ¿cómo afectan a quienes usan los modelos de forma honesta y legítima? La respuesta corta es que OpenAI ha diseñado estas protecciones para que sean lo más transparentes posible para el usuario ordinario. Los sistemas de detección conductual están calibrados para distinguir entre el uso intensivo pero legítimo —como el de un investigador o un equipo de desarrollo— y los patrones claramente extractivos de las campañas de destilación.
No obstante, es razonable anticipar que algunos usuarios con perfiles de uso atípico —volúmenes muy altos de consultas en dominios muy específicos— puedan verse afectados por falsos positivos en los sistemas de detección. OpenAI deberá afinar continuamente estos umbrales para garantizar que las defensas no se conviertan en un obstáculo para la innovación legítima.
Para los desarrolladores que construyen aplicaciones sobre la API de OpenAI, estas medidas son en gran medida positivas: protegen el valor del ecosistema al que han apostado y reducen el riesgo de que competidores desleales lleguen al mercado con capacidades similares a un costo artificialmente bajo. La sostenibilidad del modelo de frontera de OpenAI es, en última instancia, condición necesaria para que ese ecosistema siga existiendo y evolucionando.
Una Carrera Tecnológica Sin Línea de Llegada
La reducción de la tasa de éxito de los ataques al 0,2% es un logro notable, pero los expertos en seguridad son unánimes en advertir que ninguna defensa es permanente. Las técnicas de ataque evolucionan continuamente, y los actores maliciosos con suficientes recursos e incentivos económicos seguirán buscando nuevas formas de superar las barreras que OpenAI ha levantado. La suspensión masiva de cuentas es una respuesta táctica eficaz, pero los operadores más sofisticados de estas campañas disponen de infraestructuras diseñadas para rotar identidades y orígenes de forma automatizada.
Lo que hoy OpenAI ha demostrado es que cuenta con la voluntad institucional y la capacidad técnica para tomar este problema en serio y responder con medidas de proporcional sofisticación. En un sector donde la velocidad del cambio tecnológico supera con frecuencia a la capacidad regulatoria y legal de dar respuesta, esa determinación puede ser tan importante como cualquier mecanismo técnico concreto.
La protección del razonamiento interno de los modelos de IA no es solo una cuestión de propiedad intelectual o ventaja competitiva. Es, en un sentido más profundo, una cuestión sobre quién controla las capacidades más avanzadas de la inteligencia artificial y bajo qué condiciones se accede a ellas. Las decisiones que OpenAI y sus competidores tomen en los próximos meses sobre cómo proteger —o no proteger— sus modelos de frontera tendrán consecuencias que trascenderán con mucho el ámbito empresarial para moldear el paisaje tecnológico global de los próximos años.